مقال · الذكاء الاصطناعي والطب
الـ AI شخّص الحالات الصعبة أحسن من الدكاترة؟
قراءة هادية في دراسة Microsoft الجديدة عن نظام MAI-DxO: إزاي اشتغل، الأرقام بالظبط، الحاجات اللي محدش بيقولها، والخطوة الجاية.
محمد مصلوح · · قراءة 6 دقايق

الخبر في سطرين
في 22 أكتوبر 2026 نشرت Microsoft في مجلة Science نتيجة نظام اسمه MAI-DxO. النظام شخّص صح 83% من أصعب الحالات الطبية المنشورة، والدكاترة اللي اتقارن بيهم شخّصوا صح 36% بس.
الرقم كبير، وانتشر بسرعة. بس زي أي دراسة، التفاصيل هي اللي بتقول الحكاية كاملة.

مش AI واحد، لجنة دكاترة كاملة
MAI-DxO مش موديل واحد بيرد على سؤال. هو "منسّق" بيشغّل أكتر من AI مع بعض، كأنهم لجنة دكاترة قاعدين على نفس الحالة، وكل واحد ليه دور:
- واحد بيقترح التشخيصات المحتملة.
- واحد بيختار التحليل أو الأشعة اللي تفرّق بينهم.
- واحد بيعارض ويدوّر على الغلط في تفكير الباقيين.
- واحد بيراقب التكلفة عشان مايطلبوش تحاليل ملهاش لازمة.
- واحد بيراجع إن مفيش حاجة اتنست.
وبيتناقشوا مع بعض في كل خطوة لحد ما يتفقوا على تشخيص.
الاختبار: 304 حالة، خطوة بخطوة
الحالات جاية من أصعب الحالات اللي بتتنشر في مجلة New England Journal of Medicine، الحالات اللي بتتعرض أصلا لأن الوصول لتشخيصها صعب.
الفكرة المهمة إن النظام مكانش بياخد الحالة كلها مرة واحدة. كان بيبدأ بسطرين بس عن العيان، وبعدين يسأل أسئلة، ويطلب تحاليل وأشعة واحدة واحدة. وكل تحليل كان ليه تمن محسوب، زي ما بيحصل مع دكتور حقيقي قدام عيان حقيقي.

النتيجة
| التشخيص الصح | |
|---|---|
| MAI-DxO | 83.2% |
| دكاترة باطنة وممارس عام، معاهم كتب وإنترنت | 36.1% |
| نفس الدكاترة، من غير كتب وإنترنت | 22.3% |
النظام شخّص صح 83.2% من الحالات. الدكاترة (باطنة وممارس عام) شخّصوا صح 36.1% وهما معاهم كتب وإنترنت، و22.3% من غيرهم.
وفي الطوارئ؟
جربوه كمان على 325 حالة دخلت الطوارئ قبل كده، والفرق فضل كبير.
| التشخيص الصح | |
|---|---|
| MAI-DxO | 80.3% |
| الدكاترة | 46.8% |

والتكلفة؟
هنا التفصيلة اللي أغلب الأخبار عدّتها بسرعة. النسخة اللي جابت 83% مكانش ليها حد للمصاريف، وطلبت تحاليل بحوالي 5,431 دولار للحالة، وده أكتر شوية من تقدير الدكاترة (من 3,049 لـ 4,725 دولار).
لكن لما حطوا للنظام ميزانية، فضل يشخّص صح حوالي 80% وبتكلفة أقل بكتير: 80.9% بـ 2,241 دولار، و79.6% بـ 1,303 دولار بس.
| الدقة | التكلفة لكل حالة | |
|---|---|---|
| MAI-DxO، من غير ميزانية | 83.2% | $5,431 |
| MAI-DxO، بميزانية | 80.9% | $2,241 |
| MAI-DxO، بميزانية أقل | 79.6% | $1,303 |
| الدكاترة، تقدير | 36.1% | $3,049 لـ $4,725 |
التكلفة تقدير لتمن التحاليل والزيارات بالدولار. فوق وعلى الشمال أحسن: دقة أعلى وتكلفة أقل.
ومهم نعرف إن التكاليف دي تقدير لتمن التحاليل والزيارات جوه المحاكاة، مش فواتير حقيقية.
الفضل للجنة ولا للموديل؟
الدراسة جربت موديلات من شركات كتير (OpenAI وGoogle وAnthropic وMeta وDeepSeek). اللجنة رفعت دقة كل موديل، بس الفرق الأكبر كان في الموديلات الأضعف.
| الموديل لوحده | جوه اللجنة (MAI-DxO) | |
|---|---|---|
| GPT-5.5 | 72% | ≈87% |
| GPT-5 | 78.9% | ≈83% |
| Gemini 2.5 Flash | 46.4% | ≈69% |
≈ يعني تقريبا. الأعلى أحسن.
يعني جزء كبير من النتيجة جاي من قوة الموديل نفسه، واللجنة بتزوّد عليه. وفي حالات الطوارئ، اللجنة مزوّدتش حاجة تقريبا على أقوى موديل.
بس قبل ما نتحمس
- المقارنة كانت مع دكاترة باطنة وممارس عام، مش مع استشاريين متخصصين ولا فريق كامل، واللي هما في الحقيقة اللي بيمسكوا الحالات الصعبة دي.
- كل الحالات كانت متسجلة قبل كده. محدش اتعالج بالنظام ده لحد دلوقتي، والنتيجة جاية من محاكاة.
- الحالات المنشورة مختارة عشان صعبة ونادرة، وده مش شكل الشغل اليومي في أي مستشفى.
الخطوة الجاية
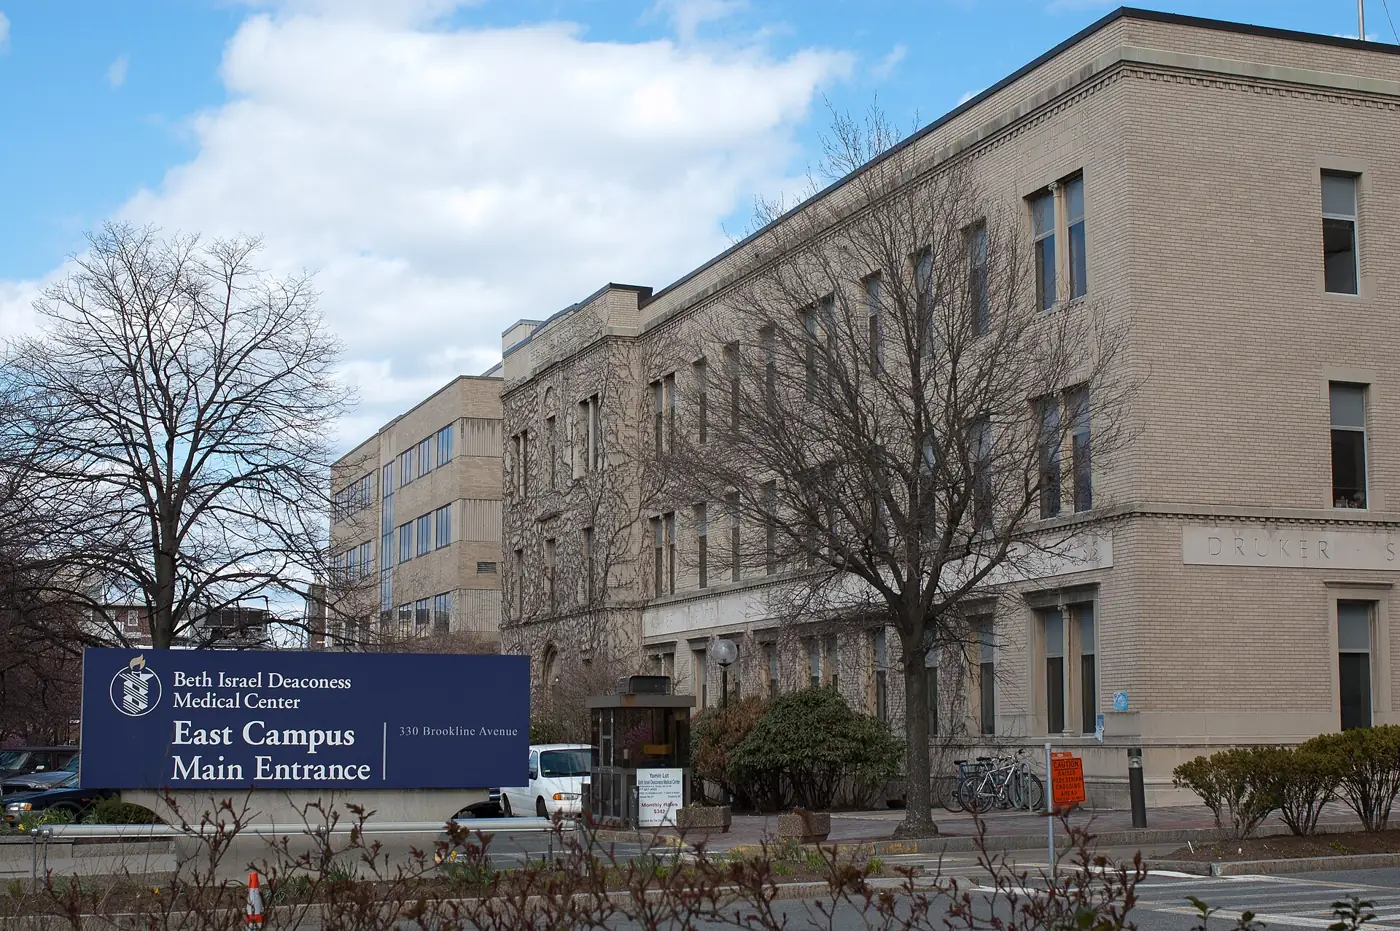
Microsoft هتجرب النظام على مرضى حقيقيين في الطوارئ والرعاية العاجلة مع مستشفى Beth Israel Deaconess في Boston: المريض ياخد رعايته العادية، ولو وافق، توصيات النظام تتقارن بقرارات الدكاترة. وبتشتغل كمان مع Mayo Clinic على موديل طبي أساسي متوقع السنة الجاية.
النتيجة دي هي اللي هتقول الكلام بجد.


وانت شايف إيه؟
تفتكر الـ AI ممكن يستبدل الدكاترة؟ قولي رأيك في الكومنتات على البوست، أو ابعتلي.
المصادر
- Microsoft Research: Sequential Diagnosis with Language Models (الورقة الأصلية، نسخة 2025)
- TechCrunch، 22 أكتوبر 2026
- The AI Insider
- TechRepublic
- The Next Web
- TechEnclave (التكلفة)
الدراسة اتنشرت في مجلة Science في 22 أكتوبر 2026.